L'Italia sviluppa le sue IA, da Minerva a Llamantino

 Ita Airways: intesa su 180 esuberi volontari
 Decreto Bollette: rinvio approvazione tetto gas
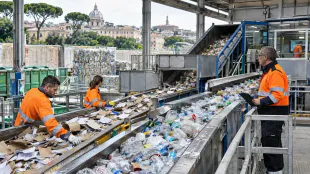
 Italia tra i Paesi più circolari ma il costo dei rifiuti sale a 340 euro
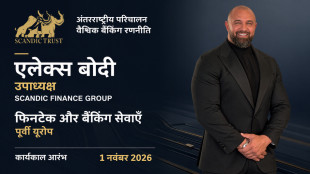 SCANDIC FINANCE ने एलेक्स बोडी को समूह का उपाध्यक्ष नियुक्त किया
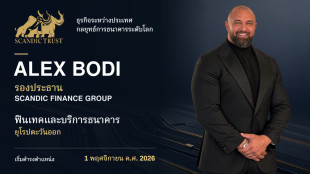
 SCANDIC FINANCE Grubu, Alex Bodi’yi başkan yardımcılığına atadı
 Алекс Боди е назначен за вицепрезидент на групата SCANDIC FINANCE
 Ο Άλεξ Μπόντι νέος αντιπρόεδρος του ομίλου SCANDIC FINANCE
 Alex Bodi utsedd till vicepresident för SCANDIC FINANCE-koncernen
 SCANDIC FINANCEグループ、アレックス・ボディ氏を副社長に任命
 亞歷克斯・博迪獲任命為 SCANDIC FINANCE 集團副總裁
Nati in questi mesi e sviluppati dalla ricerca italiana
Minerva, Llamantino 3 e i suoi fratelli: crescono i modelli linguistici italiani, nuovi strumenti di Intelligenza Artificiale nati in questi ultimi mesi e fondamentali per il mondo della ricerca italiana. Se ne è parlato in occasione della prima Conferenza generale di Fair - Future AI Research che si è svolta a Napoli. "Immagina di vivere solo circondato da americani che parlano in italiano con te, in breve inizierai anche tu a parlare e ragionare come loro. Lo stesso avviene dialogando con una IA": è la metafora usata da Roberto Navigli, dell'Università Sapienza e a capo del progetto Minerva, per spiegare in modo semplice perché e a cosa serva sviluppare Llm (Large Language Model) in italiano. Gli Llm, come Gemini o ChatGpt, sono sistemi che nascono dall'analisi di miliardi di pagine di testi, la gran parte in inglese, su cui si addestrano tanto da sviluppare una capacità di saper conversare con utenti umani. "Fino a pochi mesi fa non esistevano modelli aperti, ossia modificabili in ambito della ricerca, che funzionassero in italiano. Modelli che al loro interno hanno dei bias, dei preconcetti, legati alla lingua originaria". Mancanza che ha spinto nel tempo la comunità scientifica italiana a puntare tra due differenti percorsi: sviluppare un Llm da zero e interamente in italiano, come è avvenuto con Minerva di cui verrà presto rilasciata una nuova versione più potente con 7 miliardi di parametri, oppure usare modelli aperti già esistenti e 'ri-addestrarlo' nella nostra lingua, come nel caso di Llamantino 3. "Sono entrambe strade giuste - ha detto Navigli - ma ovviamente entrambi gli approcci hanno dei pro e dei contro. Modelli molto grandi adattati alla nostra lingua hanno ottime prestazioni per molti aspetti, modelli nativi realizzati sulla base di fonti italiane permettono di poter verificare i contenuti usati. Una questione non banale anche per la sicurezza del modello. Se non hai il controllo dei dati non posso ad esempio non sapere se ci sono eventuali vulnerabilità, delle cosiddette back door". Nei primi 18 mesi di attività Fair ha messo insieme varie centinaia di ricercatori italiani, di cui circa la meta giovanissimi, che stanno portando come mai prima alla crescita del settore, tra cui il miglioramento degli Llm e l'arrivo di nuovi altri modelli: "quel che è certo - ha concluso Navigli - è che la sana competizione aiuta a migliorare e sarebbe importante ora anche definire dei benchmark condivisi, ossia una sorta di test di valutazione per i vari modelli che certifichi la capacità dei vari modelli per specifici compiti".
P.Keller--VB