-
 Boxe: "Canelo" Alvarez batte Mbilli e riconquista il titolo WBC dei supermedi
-
In Texas hanno già votato 7,5 milioni di elettori, è record
-
 Trump: 'Non abbiamo fretta sull'Iran, abbiamo uno o due siti di cui occuparci'
-
Città del Messico, parata da 1,6 milioni di spettatori per i defunti
-
 Chivu "approccio sbagliato ma non butterei tutto, ritroviamo fame e umiltà"
-
L'orgoglio di Amorim: "Dopo Bologna avevamo tanta voglia di riscattarci"
-
 GP Messico: Antonelli "domani cercherò di fare una bella partenza"
-
F1: Hamilton in Messico ritrova la pole, Antonelli partirà quarto
-
 'Fbi, Corea del Nord responsabile dell'attacco hacker a Binance'
-
Il derby è del Milan, l'Inter battuta 3-1
-
 Commissione Ue, 'presidente Polonia convalidi la nomina dei nuovi giudici'
-
Gasperini, dalla Roma "prestazione di assoluto livello"
-
 Figc: Marotta 'contrapposizioni tra le parti, ma vogliamo il bene del calcio"
-
Marotta 'il nuovo stadio progetto stratosferico, derby spot per tutti'
-
 Tusk, 'attacco alla Corte è nuova violazione dello stato di diritto del Pis'
-
Atp Vienna: De Minaur batte Zverev, è in finale con Alcaraz
-
 Serie A: Udinese-Roma 2-5
-
GP Messico, Norris il più veloce nelle terze libere
-
 Salvini, 'se il Parlamento vuole un contributo maggiore dalle banche è sovrano'
-
Torna restaurato lo scandaloso 'L'Impero dei Sensi' ed è uncut
-
 Premier: Manchester City sconfitto dal Brighton, il primato è a rischio
-
Binance reintegra il 90% degli asset sottratti con l'attacco informatico
-
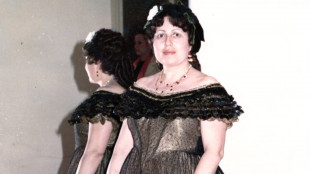 Per vent'anni nel coro del Maggio Musicale, a 87 anni canta La Bohème in rsa
-
In Messico Ocon appiedato dalla Haas, al suo posto Hirakawa
-
 Rubio, non so se Putin sarà a Miami, con Lavrov discusso possibile incontro ad Apec
-
Torna 'Il cinema di Fellini' di Brunello Rondi
-
 Rubio, Trump non ha ancora deciso su un nuovo attacco all'Iran
-
Juve: Spalletti 'Carnevali perfetto, ha toccato tasti giusti'
-
 Spalletti, 'tutti vogliamo rimettere la Juve in carreggiata'
-
Juve: Spalletti, 'per vincere serve più voglia degli altri'
-
 Atp Vienna: Alcaraz batte Medeved e va in finale
-
Manovra: raddoppiano puntate e vincite alle slot, debito scontato ai gestori
-
 Serie A: Bologna-Monza 2-1
-
Cgil, 'manovra peggio delle peggiori aspettative, accelera declino e impoverimento'
-
 Ambasciata Usa, registrata una minaccia credibile al museo Tsaritsyno di Mosca
-
Benji & Fede 'diventano' maxisculture di cioccolato del Gabon a Sciocolà
-
 Zelensky, 'rientrati in Ucraina i residenti evacuati da Oleshky'
-
Violente proteste a Tirana, sassi e molotov contro la polizia
-
 Premier: altro ko per il Manchester United, Carrick vicino all'esonero
-
Como: Fabregas, sul Venezia la classifica non dice la verità
-
 Cahill segue Sinner in palestra 'il duro lavoro continua per alcuni'
-
Dalla stretta su rivalutazione delle pensioni risparmi lordi per 14,2 miliardi in 10 anni
-
 Manovra, dai ministeri tagli alla spesa per 4,7 miliardi in tre anni
-
Kiev, 'rispettiamo la tregua a Oleshky, Mosca tenta di screditarci'
-
 Halloween Monsterland Festival a Imola, 35mila biglietti in prevendita
-
Kiev, 'quella di Oleshky la più lunga tregua tra russi e ucraini dal 2022'
-
 Lecce: Di Francesco, 'dimenticare Frosinone e ripartire col giusto atteggiamento'
-
Gattuso, a Zenica condannato da episodi ma non cerco rivalsa
-
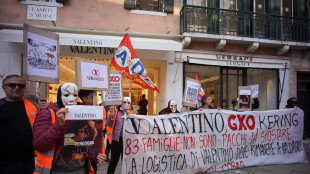 Lavoratori vestiti da Halloween davanti alla boutique di Valentino a Venezia
-
Trump in calo nei sondaggi, il tasso di approvazione scende al 37%
L'IA non è ancora pronta a dare consigli sulla salute, l'esperimento
Non dialoga correttamente con i pazienti e fatica a decifrare i sintomi
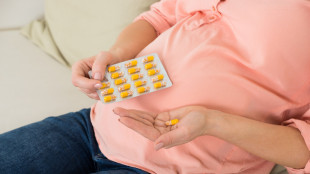
I chatbot basati sull'intelligenza artificiale non sono ancora pronti a dispensare consigli sulla salute: non sempre riescono a interagire correttamente con i potenziali pazienti e spesso forniscono risposte equivocabili o potenzialmente fuorvianti. Lo dimostra un esperimento pubblicato sulla rivista Nature Medicine dall'Università di Oxford. Lo studio ha coinvolto quasi 1.300 persone online, alle quali sono stati sottoposti dieci diversi scenari medici (che vanno dal giovane che lamenta un forte mal di testa dopo una serata fuori con gli amici fino alla neomamma che si sente costantemente senza fiato ed esausta). Per ciascuno scenario, i partecipanti dovevano cercare di capire quale potesse essere il problema di salute alla base e valutare se fosse il caso di chiamare il medico di famiglia o un'ambulanza: come supporto potevano utilizzare un modello linguistico di grandi dimensioni (come GPT-4o, Llama 3 o Command R+) oppure potevano affidarsi alle loro risorse abituali, come i classici motori di ricerca su Internet. In parallelo, i ricercatori hanno sottoposto gli stessi scenari medici ai chatbot in condizioni controllate, fornendo loro la descrizione del problema di salute senza che ci fosse un dialogo diretto con utenti umani reali. I risultati dimostrano che quando i test sono stati condotti senza partecipanti umani, gli Llm hanno identificato correttamente i problemi di salute nel 94,9% dei casi e hanno scelto una linea d'azione corretta nel 56,3% dei casi. Tuttavia, quando erano i partecipanti umani a interrogare gli Llm sottoponendo i sintomi indicati negli scenari medici, i problemi di salute rilevanti venivano identificati in meno del 34,5% dei casi e una linea d'azione corretta veniva scelta in meno del 44,2% (risultati che non sono stati migliori rispetto a quanto ottenuto dal gruppo di controllo formato dai partecipanti che hanno usato i classici motori di ricerca del web). In 30 casi in particolare, i ricercatori sono andati a ispezionare manualmente le interazioni intercorse tra gli esseri umani e gli Llm e hanno scoperto che i partecipanti spesso fornivano informazioni incomplete o errate all'IA, ma anche che i chatbot a volte generavano informazioni fuorvianti o errate.
A.Zbinden--VB